Le 17 novembre 2026, OpenAI lance GPT-6.2 Astra et Sol pour les travaux professionnels, dans ChatGPT Work, Codex et son API. Cette interface permet de connecter les modèles aux outils de votre entreprise. Pour choisir, nous privilégions le coût d’une tâche correctement terminée, temps de correction compris, plutôt que le seul prix affiché.
GPT-6.2 Astra et Sol : que change cette version ?
OpenAI destine Astra aux projets complexes et Sol aux usages quotidiens, avec une priorité à l’efficacité. Les deux modèles sont disponibles dans ChatGPT Work et Codex pour les abonnements Plus, Pro, Enterprise et Edu. Certaines fonctions nécessitent une activation par l’administrateur de l’espace de travail.
Pour les intégrations, les identifiants sont gpt-6.2-astra et gpt-6.2-sol. Un token est un fragment de texte utilisé pour mesurer la consommation. L’entrée correspond aux éléments envoyés au modèle ; la sortie, aux éléments qu’il produit.
Au tarif standard, Astra coûte 8 USD en entrée et 40 USD en sortie par million de tokens. La lecture d’entrées en cache, déjà conservées pour réutilisation, coûte 0,40 USD. Sol affiche respectivement 2 USD, 10 USD et 0,10 USD.
Selon OpenAI, les prix d’entrée et de sortie d’Astra baissent de 20 % par rapport à GPT-6 Astra. La baisse atteint 60 % pour les entrées en cache. L’éditeur annonce aussi un meilleur rendement dans ses évaluations de tâches professionnelles.
Pourquoi le tarif ne suffit-il pas pour votre budget ?
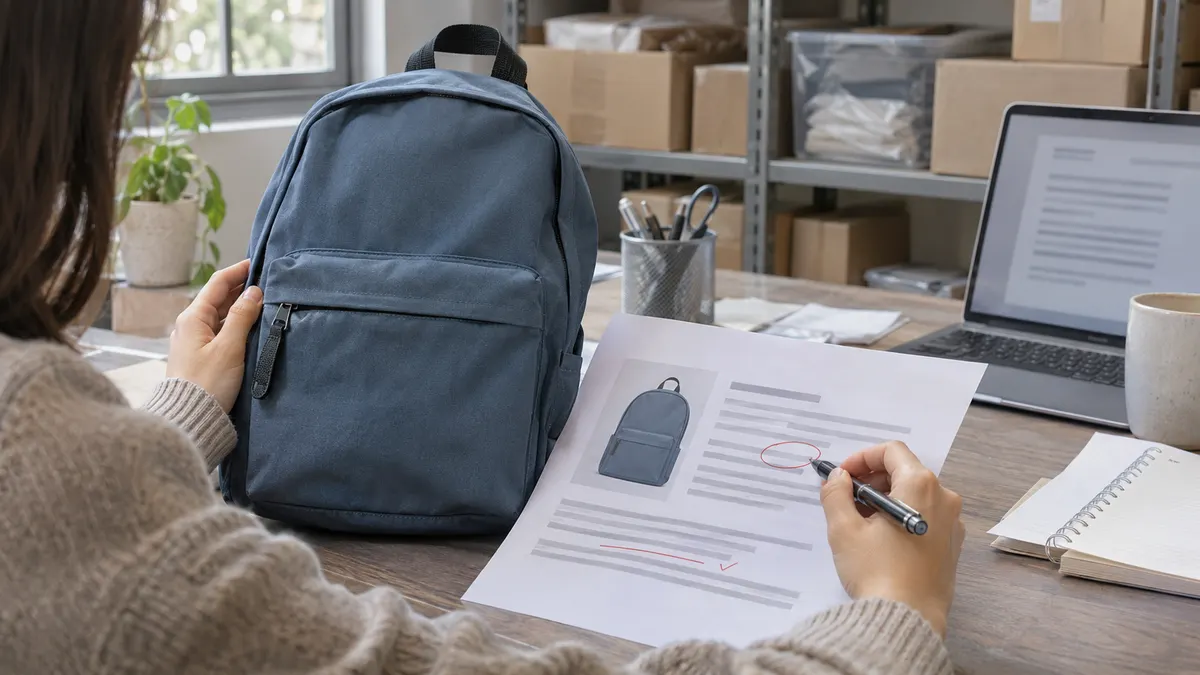
Prenons une boutique en ligne qui utilise l’IA pour préparer ses fiches produits et examiner le code de son site. Pour une fiche, l’équipe vérifie les caractéristiques, le ton et l’absence de promesse inventée. Pour une modification du panier, elle contrôle aussi le fonctionnement après correction.
Dans ce scénario, comparez les modèles sur un résultat accepté par la personne responsable. Additionnez les appels nécessaires, les nouvelles tentatives et le temps de relecture. Une réponse rapide qui exige plusieurs reprises ne représente pas le même travail qu’une proposition directement exploitable.
Attention aussi aux conditions des tarifs. Au-delà de 272 000 tokens d’entrée, les prix d’entrée et de cache doublent pour toute la requête ; ceux de sortie sont multipliés par 1,5. L’écriture dans le cache possède également son propre tarif, distinct de sa lecture.
Évitez donc d’envoyer systématiquement tout le catalogue et tout le code à chaque demande. Préparez les informations utiles à la tâche et demandez un résultat de longueur adaptée. Pour une fiche produit, précisez les champs attendus et fournissez les caractéristiques validées.
Comment comparer les modèles sur vos propres tâches ?
Avant de changer une automatisation, constituez un test reproductible de 20 tâches. Répartissez-les entre développement Next.js, sécurité applicative, rédaction SEO et analyse commerciale. Ce nombre sert à organiser un premier essai ; il ne garantit pas une mesure représentative de toute votre activité.
Pour notre boutique, cela signifie corriger un composant du site, examiner les droits d’accès, rédiger une fiche et analyser des ventes. Fournissez à chaque modèle les mêmes documents et les mêmes consignes. Conservez les réglages, les réponses et les résultats des contrôles pour pouvoir refaire la comparaison.
Définissez la réussite avant de lancer les demandes. Une fiche respecte les données produit ; une analyse commerciale retrouve les chiffres du fichier fourni. Une correction de code passe les tests prévus sans casser une fonction existante.
Pour les contrôles de sécurité, notre actualité sur GitHub AI Scan complète ce sujet. Intégrez les alertes confirmées et les erreurs de diagnostic à votre grille d’évaluation. Ne notez pas seulement la clarté du rapport.
Quelles vérifications demander à votre équipe ?
- Qualité et corrections : qui valide chaque résultat, selon quels critères, et combien de reprises faut-il ? Gardez aussi les échecs dans le bilan pour éviter une comparaison limitée aux réussites.
- Délai réel : combien de temps s’écoule entre la demande et le résultat utilisable ? Mesurez séparément l’attente du modèle et l’intervention humaine, notamment pour les tâches qui bloquent une commande.
- Coût total : combien coûte chaque tâche acceptée, avec les appels, les outils utilisés et la relecture ? Présentez les résultats par famille de tâches avant de choisir un modèle pour chaque usage.